Tutorial 6: Vínculo de Dados Socioeconômicos
Equipe climasus4r
17/10/2026
Source:vignettes/06-socioeconomico.Rmd
06-socioeconomico.RmdObjetivo
Ao final deste tutorial você será capaz de vincular variáveis do Censo Demográfico brasileiro aos dados de saúde já espacializados e calcular indicadores socioeconômicos e epidemiológicos padronizados. Você aprenderá a:
-
descobrir quais variáveis do censo estão
disponíveis com
sus_census_select(); -
baixar e agregar microdados (ou setores) do censo
ao nível municipal e juntá-los aos dados de saúde com
sus_census_join()(via pacotecensobr); -
calcular indicadores como envelhecimento,
dependência e cobertura de saneamento — com intervalos de
confiança — usando
sus_socio_compute_indicators(); -
consultar o catálogo completo de indicadores com
sus_socio_list_indicators().
O vínculo socioeconômico é a sexta etapa do pipeline
do climasus4r. Ela exige que os dados já tenham passado
pela junção espacial (Tutorial 5), pois a chave do
vínculo é o código IBGE de 7 dígitos do município
(code_muni_7).
Contexto científico
Estudos de clima e saúde raramente podem tratar a população como homogênea. A vulnerabilidade social — pobreza, baixa escolaridade, saneamento precário, estrutura etária envelhecida — modula a relação entre exposição ambiental (temperatura, poluição) e desfechos de saúde, atuando tanto como confundidor quanto como modificador de efeito (Gouveia, Hajat & Armstrong, 2003; Hajat, O’Connor & Kosatsky, 2010). Idosos em domicílios sem infraestrutura adequada, por exemplo, sofrem mais durante ondas de calor.
No Brasil, a fonte oficial dessas variáveis é o Censo
Demográfico do IBGE, acessível programaticamente pelo pacote
censobr (Pereira & Barbosa, 2023). O
climasus4r encapsula esse acesso em
sus_census_join(), baixando o dataset escolhido,
filtrando apenas os municípios presentes nos dados de saúde
antes de carregar à memória (otimização Arrow/Parquet),
agregando os microdados ao nível municipal e fazendo a junção pela chave
geográfica.
A partir dessas variáveis,
sus_socio_compute_indicators() calcula um conjunto de
indicadores padronizados (demográficos,
socioeconômicos, de mortalidade, morbidade, saúde materno-infantil e
recursos de saúde), cada um com sua fórmula,
multiplicador e método de incerteza
declarados em um catálogo interno.
Aviso metodológico (viés ecológico). Indicadores municipais descrevem o agregado, não o indivíduo: associações observadas entre a vulnerabilidade média de um município e seus desfechos de saúde não se transferem automaticamente para pessoas (falácia ecológica). A escala de agregação também importa — o mesmo fenômeno pode mudar de sinal conforme a unidade (problema da unidade de área modificável, MAUP). Use estes indicadores como covariáveis de área, não como atributos individuais.
Caso condutor. Investigamos a temperatura e os desfechos de saúde em idosos (60+) na Região Metropolitana de São Paulo, 2014–2019. No Tutorial 5 espacializamos os óbitos respiratórios (J00–J99) e cardiovasculares (I00–I99) por município. Aqui vinculamos variáveis do Censo 2010 e calculamos indicadores de vulnerabilidade (envelhecimento, dependência, cobertura de esgoto e água) que servirão de covariáveis/modificadores de efeito na modelagem clima–saúde dos próximos tutoriais.
Dados utilizados
| Item | Valor | Papel no caso |
|---|---|---|
| Entrada |
dados/caso_espacial.rds (Tutorial 5) |
Óbitos espacializados por município (RMSP) |
| Dataset do censo |
"population" (Censo 2010) |
População por município (idosos, jovens, ativos) |
| Chave de vínculo |
code_muni_7 (IBGE, 7 dígitos) |
Liga saúde × censo |
| Indicadores | envelhecimento, dependência, esgoto, água | Vulnerabilidade municipal |
| Saída | dados/caso_socio.rds |
Entrada do Tutorial 7 (clima INMET) |
Todos os dados são públicos e reais (IBGE/Censo via
censobr).
Pipeline completo
Os blocos abaixo reproduzem o que o script
scripts/tutorial_06_socioeconomico.R executa. Comece
carregando o pacote e a entrada encadeada:
library(climasus4r)

# Saída do Tutorial 5: óbitos espacializados por município (stage "spatial",
# com a coluna code_muni_7 — chave do vínculo).
caso_espacial <- readRDS("dados/caso_espacial.rds")
Passo 1 — Descobrir variáveis do censo
(sus_census_select())
Antes de baixar o censo, vale descobrir os códigos
das variáveis. Em uso interativo, output = "browser" abre
uma interface HTML pesquisável; em scripts, prefira
output = "codes", que retorna um vetor de
códigos sem abrir o navegador:
# Códigos das variáveis de população do Censo 2010 (uso programático):
vars_pop <- sus_census_select(
  dataset = "population",  # "all", "population", "households", "families", ...
  year    = 2010,           # 2010 (padrão) ou 2000
  output  = "codes",        # "browser" (padrão), "console" ou "codes"
  lang    = "pt",
  verbose = FALSE
)
head(vars_pop)
Passo 2 — Vincular o censo (sus_census_join())
sus_census_join() baixa o dataset escolhido via
censobr, filtra apenas os municípios
presentes em code_muni_7, agrega os microdados ao
nível municipal (aggregation_fun) e faz o
left_join. Exige que os dados estejam no estágio
>= "spatial":
caso_enriquecido <- sus_census_join(
  df              = caso_espacial,
  dataset         = "population",     # "population"/"households"/"families"/
                                       # "mortality"/"emigration"/"tracts"
  year            = 2010,             # 2010 (padrão) ou 2000
  census_vars     = head(vars_pop, 6),# NULL = todas (não recomendado)
  aggregation_fun = "sum",            # "sum","mean","median","min","max","sd",
                                       # "q25","q75","q95","q99"
  use_cache       = TRUE,             # cache local do censobr
  cache_dir       = "~/.climasus4r_cache/census",
  lang            = "pt",
  verbose         = TRUE
)
Cada variável numérica agregada recebe o sufixo do modo de
agregação (ex.: V0001 agregada por soma vira
V0001_sum). Se a entrada for um objeto sf, a
geometria é preservada na saída.
Para usar dados de setores censitários em vez de
microdados, troque dataset = "tracts" e escolha a tabela em
tracts_dataset (ex.: "Basico",
"DomicilioRenda", "Pessoa03"):
caso_setores <- sus_census_join(
  df             = caso_espacial,
  dataset        = "tracts",
  tracts_dataset = "Basico",   # "Basico","Domicilio01/02","DomicilioRenda",
                                # "Pessoa01"..."Pessoa13","ResponsavelRenda", ...
  year           = 2010,
  lang           = "pt"
)
Passo 3 — Consultar o catálogo de indicadores
(sus_socio_list_indicators())
Antes de calcular, inspecione o que está disponível. Sem rede,
retorna um tibble com id, name,
category, required_cols, formula,
multiplier, unit,
uncertainty_method e source:
catalogo <- sus_socio_list_indicators(lang = "pt")

# Filtrar por categoria, se desejar:
sus_socio_list_indicators(lang = "pt", category = "mortality")
Passo 4 — Calcular indicadores
(sus_socio_compute_indicators())
Os indicadores são definidos em espaço de fórmula
(nomes como pop_elderly, total_hh). Como as
colunas vindas do censo têm outros nomes (ex.: V0001_sum),
use col_mapping para conectar nomes de
fórmula → colunas reais:
caso_socio <- sus_socio_compute_indicators(
  df               = caso_enriquecido,
  indicators       = c("aging_index", "dependency_ratio",
                       "sewage_connection_rate", "water_connection_rate"),
  col_mapping = list(
    pop_elderly = "pop_65_plus_sum",  # aponte para as colunas agregadas reais
    pop_young   = "pop_0_14_sum",
    pop_working = "pop_15_64_sum",
    pop_total   = "V0001_sum",
    total_hh    = "V003_sum",
    hh_sewage   = "V0207_sum",
    hh_water    = "V0208_sum"
  ),
  confidence_level = 0.95,   # IC de Poisson (taxas) / Wilson (proporções)
  add_ci           = TRUE,   # adiciona colunas ind_<id>_low / ind_<id>_high
  lang             = "pt",
  verbose          = TRUE
)
Cada indicador calculado vira uma coluna ind_<id>
(ex.: ind_aging_index), e — quando o método de incerteza
não é "none" e add_ci = TRUE — também
ind_<id>_low e ind_<id>_high. Se
indicators = NULL, a função detecta
automaticamente todos os indicadores cujas colunas exigidas
estão presentes (após o col_mapping); indicadores sem as
colunas necessárias são pulados com aviso, nunca
interrompem a execução.
Ao final, caso_socio é salvo (com
save_tbl() no script) e alimenta o Tutorial 7 (Clima
baseado em estações — INMET).
Características das funções
sus_census_select()
Explorador das variáveis do censo. Ajuda a descobrir
códigos para usar em
sus_census_join(census_vars = ...).
| Argumento | Essencial? | Descrição |
|---|---|---|
dataset |
recomendado |
"all" (padrão), "population",
"households", "families",
"mortality", "emigration",
"tracts"
|
year |
opcional |
2010 (padrão) ou 2000
|
output |
recomendado |
"browser" (HTML interativo, padrão),
"console" ou "codes" (vetor) |
lang |
opcional |
"pt" (padrão), "en",
"es"
|
verbose |
opcional | Mensagens informativas |
Retorno: com "codes", um vetor de
caracteres com os códigos; com
"browser"/"console", retorna invisível um
data.frame (e abre/imprime a interface).
sus_census_join()
Vincula variáveis do censo (microdados ou setores) aos dados de
saúde. Wrapper de censobr::read_population(),
read_households(), read_tracts(), etc.
| Argumento | Essencial? | Descrição |
|---|---|---|
df |
sim |
climasus_df/sf em estágio
>= "spatial", com code_muni_7
|
dataset |
sim |
"population" (padrão), "households",
"families", "mortality",
"emigration", "tracts"
|
tracts_dataset |
só tracts
|
Tabela de setores: "Basico" (padrão),
"DomicilioRenda", "Pessoa01..13", … |
year |
opcional |
2010 (padrão) ou 2000
|
census_vars |
recomendado | Vetor de códigos (use sus_census_select());
NULL = todas |
aggregation_fun |
opcional |
"sum" (padrão), "mean",
"median", "min", "max",
"sd", "q25", "q75",
"q95", "q99"
|
join_muni_col |
opcional | Coluna do código IBGE; NULL detecta padrões SUS |
use_cache / cache_dir
|
recomendado | Cache do censobr
(~/.climasus4r_cache/census) |
translate_columns /
standardize_values
|
opcional | Traduz nomes e rótulos (padrão TRUE) |
lang / verbose
|
opcional | Idioma e mensagens |
Retorno: o mesmo df (ou
sf) com colunas adicionais do censo (sufixadas pelo modo de
agregação, ex.: _sum); metadados avançam para
stage = "census".
sus_socio_compute_indicators()
Calcula indicadores padronizados sobre as colunas presentes, com intervalos de confiança opcionais.
| Argumento | Essencial? | Descrição |
|---|---|---|
df |
sim |
climasus_df em estágio >= "spatial"
(saída de sus_census_join()) |
indicators |
opcional | Vetor de IDs; NULL = todos os calculáveis
(auto-detecção) |
col_mapping |
recomendado | Lista nomeada: nome de fórmula → coluna real (ex.:
list(total_hh = "V003_sum")) |
confidence_level |
opcional | Nível de confiança (padrão 0.95) |
add_ci |
opcional |
TRUE (padrão) adiciona
ind_<id>_low/_high
|
lang / verbose
|
opcional | Idioma e mensagens |
Retorno: o climasus_df com colunas
ind_<id> (e _low/_high
quando aplicável); sus_meta atualizado para
type = "indicators".
sus_socio_list_indicators()
Lista o catálogo completo de indicadores. Não depende de rede.
| Argumento | Descrição |
|---|---|
lang |
Idioma dos nomes: "pt" (padrão), "en",
"es"
|
category |
Filtra por categoria (ex.: "demographic",
"mortality"); NULL = todas |
Retorno: um tibble com id,
name, category, required_cols,
formula, multiplier, unit,
uncertainty_method, source.
Fórmulas
Os indicadores são calculados como uma razão (taxa/proporção) multiplicada por um fator de escala. De forma geral:
onde
é o multiplier declarado no catálogo. Exemplos usados no
caso condutor:
Intervalos de confiança. Para taxas baseadas em contagem de eventos (mortalidade, incidência, internações), usa-se o intervalo exato de Poisson (Garwood), baseado na distribuição Gama:
Para proporções (coberturas, %), usa-se o intervalo de escore de Wilson:
com
,
o número de eventos e
o denominador. Razões com numeradores complexos ou índices diretos (ex.:
Gini) não recebem IC (uncertainty_method = "none").
Resultados ilustrados
| id | name | category | unit | uncertainty_method | source |
|---|---|---|---|---|---|
| dependency_ratio | Razao de Dependencia | demographic | % | none | census |
| aging_index | Indice de Envelhecimento | demographic | % | none | census |
| urbanization_rate | Taxa de Urbanizacao | demographic | % | binomial | census |
| illiteracy_rate | Taxa de Analfabetismo | socioeconomic | % | binomial | census |
| water_connection_rate | Cobertura de Agua Encanada | socioeconomic | % | binomial | census |
| sewage_connection_rate | Cobertura de Esgoto | socioeconomic | % | binomial | census |
| gini_index | Indice de Gini | socioeconomic | index (0-1) | none | census |
| infant_mortality_rate | Taxa de Mortalidade Infantil | mortality | per 1,000 live births | poisson | sim_sinasc |
| maternal_mortality_ratio | Razao de Mortalidade Materna | mortality | per 100,000 live births | poisson | sim_sinasc |
| premature_dcn_mortality | Mortalidade Prematura por DCNT | mortality | per 100,000 (30-69 years) | poisson | sim |
| homicide_rate | Taxa de Homicidios | mortality | per 100,000 | poisson | sim |
| traffic_mortality_rate | Taxa de Mortalidade por Transito | mortality | per 100,000 | poisson | sim |
| arbovirus_incidence_rate | Taxa de Incidencia de Arboviroses | morbidity | per 100,000 | poisson | sinan |
| tb_incidence_rate | Taxa de Incidencia de Tuberculose | morbidity | per 100,000 | poisson | sinan |
| icsap_hospitalization_rate | Taxa de Internacoes por ICSAP | morbidity | per 10,000 | poisson | sih |
| respiratory_hospitalization_rate | Taxa de Internacoes Respiratorias | morbidity | per 10,000 | poisson | sih |
| low_birth_weight_proportion | Proporcao de Baixo Peso ao Nascer | maternal_child | % | binomial | sinasc |
| general_fertility_rate | Taxa de Fecundidade Geral | maternal_child | per 1,000 women (15-49 years) | poisson | sinasc |
| cesarean_proportion | Proporcao de Partos Cesareos | maternal_child | % | binomial | sinasc |
| prenatal_early_coverage | Cobertura de Pre-natal Precoce | maternal_child | % | binomial | sinasc |
| beds_per_capita | Leitos por Mil Habitantes | health_resources | per 1,000 | none | cnes |
| doctors_per_capita | Medicos por Mil Habitantes | health_resources | per 1,000 | none | cnes |
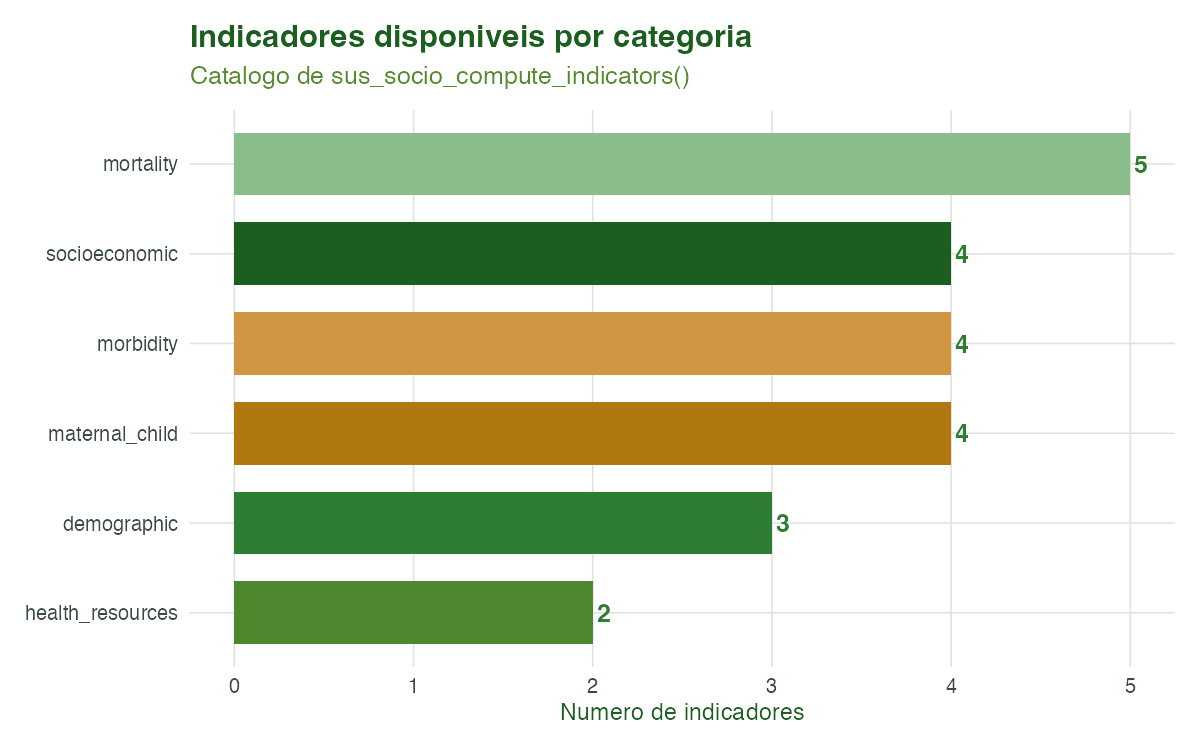
Figura 1. Número de indicadores disponíveis por
categoria no catálogo de sus_socio_compute_indicators(). As
categorias cobrem demografia, vulnerabilidade socioeconômica,
mortalidade, morbidade, saúde materno-infantil e recursos de saúde.
| name_muni | ind_aging_index | ind_dependency_ratio | ind_sewage_connection_rate | ind_water_connection_rate |
|---|---|---|---|---|
| Campinas | 63.2 | 55.9 | 84.8 | 88.7 |
| Campinas | 72.6 | 44.2 | 88.5 | 88.4 |
| Campinas | 55.1 | 39.1 | 90.1 | 97.1 |
| Campinas | 47.3 | 52.1 | 89.8 | 96.8 |
| Campinas | 74.5 | 43.3 | 95.8 | 97.2 |
| Campinas | 44.1 | 42.9 | 92.8 | 97.6 |
| Campinas | 69.0 | 42.9 | 81.0 | 88.2 |
| Campinas | 66.0 | 60.7 | 93.1 | 88.4 |
| Campinas | NA | NA | NA | NA |
| Campinas | NA | NA | NA | NA |
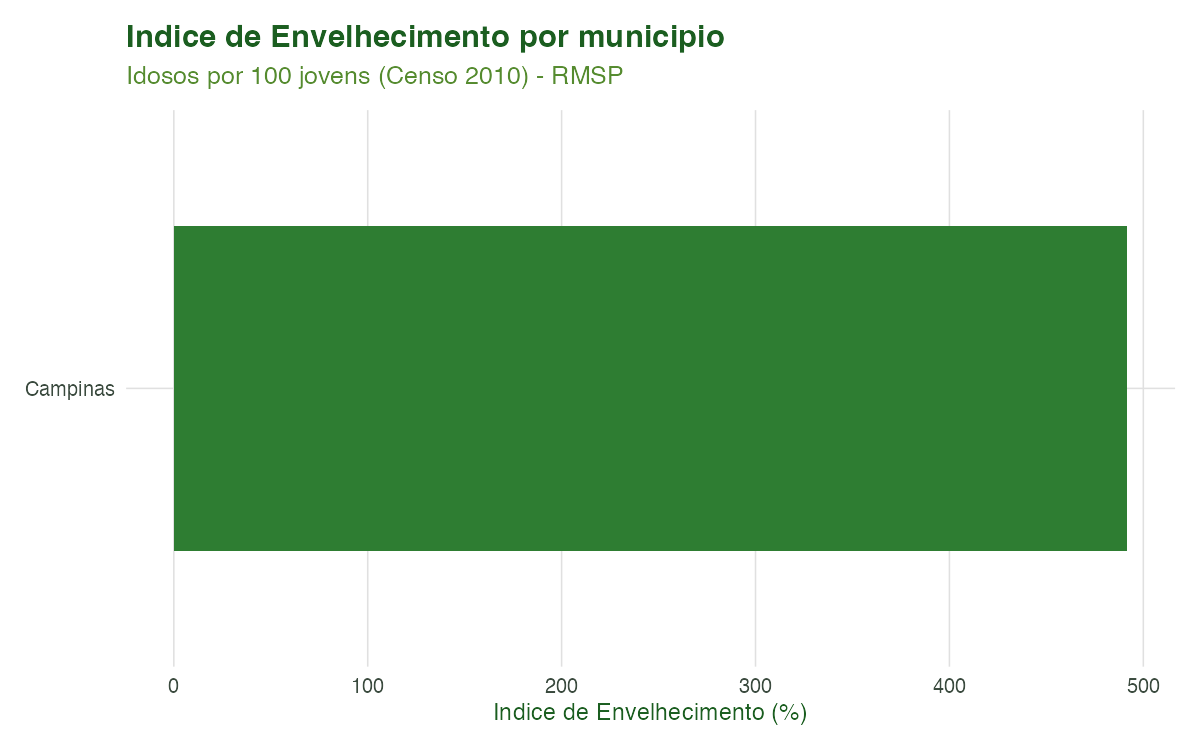
Figura 2. Ranking municipal pelo Índice de Envelhecimento (idosos por 100 jovens, Censo 2010) na RMSP. Municípios mais envelhecidos tendem a concentrar maior risco frente a extremos de temperatura.
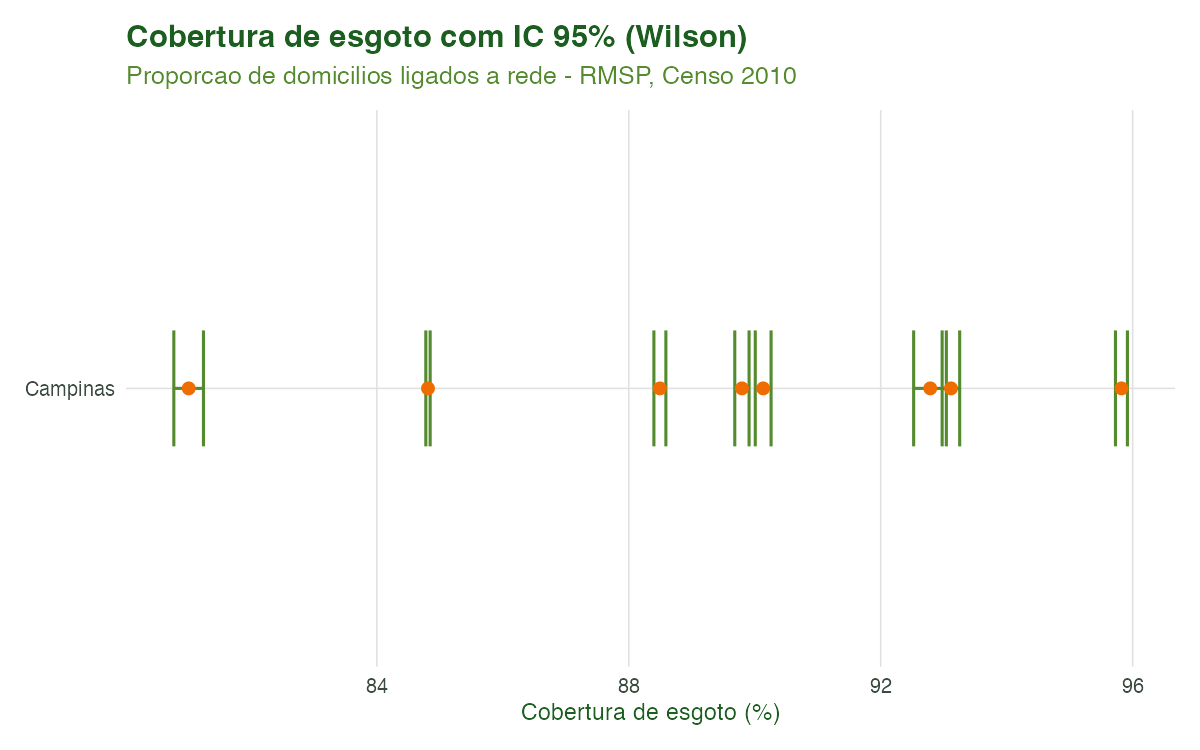
Figura 3. Cobertura de esgoto por município com
intervalo de confiança de 95% (escore de Wilson), como produzido por
add_ci = TRUE. A barra de erro comunica a incerteza da
estimativa de proporção.
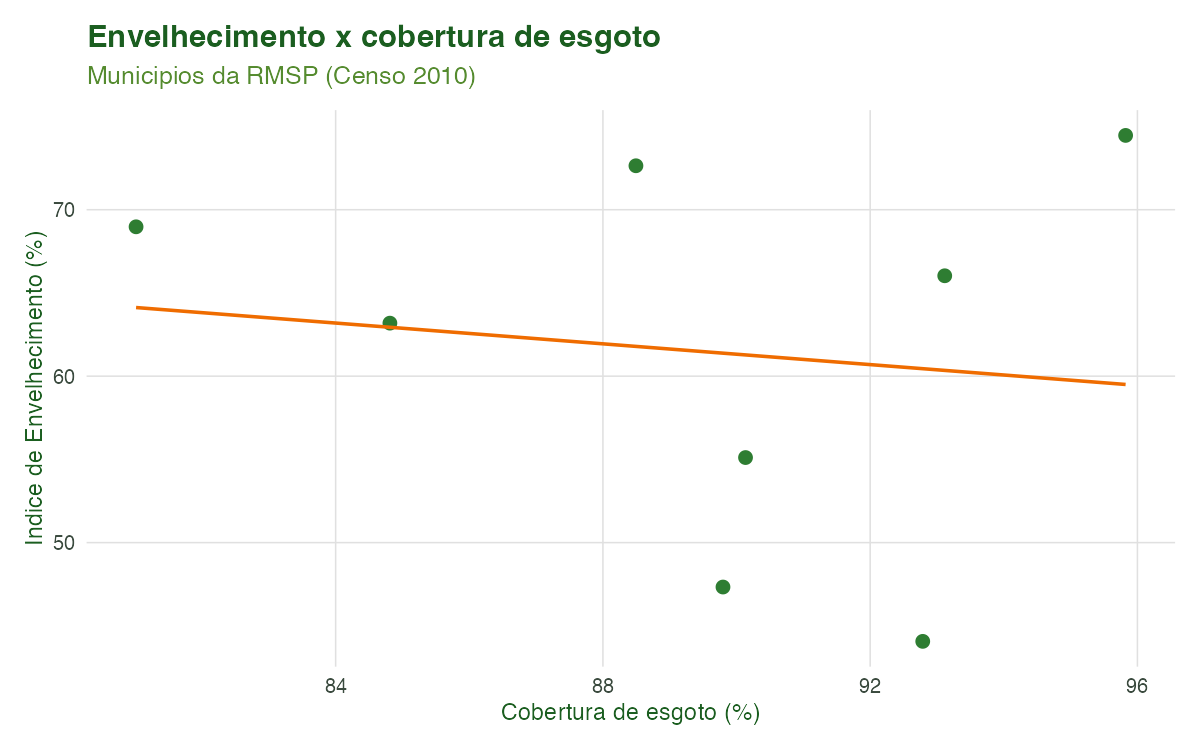
Figura 4. Relação entre envelhecimento e cobertura de esgoto nos municípios da RMSP. Cruzar vulnerabilidade demográfica e de infraestrutura ajuda a levantar hipóteses de confundimento e modificação de efeito na relação temperatura–saúde dos próximos tutoriais.
Referências
- Pereira, R. H. M., & Barbosa, R. J. (2023). censobr: Download Data from Brazil’s Population Census. R package version 0.4.0. https://CRAN.R-project.org/package=censobr. DOI: 10.32614/CRAN.package.censobr.
- Gouveia, N., Hajat, S., & Armstrong, B. (2003). Socioeconomic differentials in the temperature–mortality relationship in São Paulo, Brazil. International Journal of Epidemiology, 32(3), 390–397.
- Hajat, S., O’Connor, M., & Kosatsky, T. (2010). Health effects of hot weather: from awareness of risk factors to effective health protection. The Lancet, 375(9717), 856–863.
- IBGE — Instituto Brasileiro de Geografia e Estatística. Censo Demográfico 2010. Rio de Janeiro: IBGE.